企业把模型投入生产后,需要同时规划服务器、网络、存储和平台软件。采购 GPU 只是其中一部分。
评估 AI 基础设施时,除峰值性能外,还应关注资源利用率、故障恢复时间和上线周期。
生产环境新增的四类需求
单机通常可以满足早期模型评估。进入生产环境后,还需要处理多团队共享、资源隔离、任务排队和容量规划。
- 计算:根据训练、微调和推理负载选择 GPU 密度。
- 网络:根据分布式任务规划东西向带宽和低时延互联。
- 存储:评估数据准备、模型加载和检查点写入速度。
- 平台:配置资源编排、监控、权限和计量。
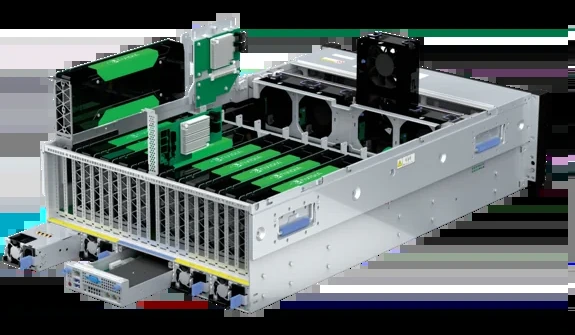
设备到场前确认交付条件
机柜功率、供电冗余、制冷条件和网络拓扑应在设备到场前确认。标准配置、预集成测试和上线清单有助于减少现场调整。
霄擎算力提供服务器、存储、网络和平台软件的选型、集成与部署服务。